 HOIBLOG
먼저 읽는 요약
- 정렬 전: 한 행의 의미를 정하고, 원본과 고정된 행 식별자를 보존합니다.
- 삭제 전: 이름이 아닌 업무상 중복 기준으로 후보를 찾고, 제외할 행을 기록합니다.
- 완료 전: 행수·수량 합계와 함께 고유ID별 사람·상품·수량의 연결을 원본과 대조합니다.
엑셀에서 수량을 작은 순서대로 정렬했는데 합계는 그대로입니다. 그러면 자료도 안전할까요? 수량 열만 움직였다면 합계는 그대로이면서 각 신청자에게 붙은 수량은 달라질 수 있습니다. 정렬은 덧셈 결과를 바꾸지 않고도 배송 대상을 틀리게 만들 수 있는 작업입니다. Microsoft 역시 큰 범위 안의 일부만 따로 정렬하면 원래 데이터의 연결 관계가 끊길 수 있다고 경고합니다. 범위와 표 정렬
따라서 이 글의 질문은 “어떤 정렬 버튼을 누르나요?”에서 한 단계 더 나아갑니다. 정리 후에도 한 행의 사람·상품·수량이 원래 관계를 유지하는지, 중복 제거로 빠진 행이 정말 제외 대상이었는지 어떻게 확인할까요? 이미 Excel에 열린 자료를 대상으로 원본 보존, 표 정리, 정렬, 중복 판단, 검산, 실패 복구의 순서로 진행합니다. 안내 기준일은 2026년 10월 7일입니다. 아래 신청자료와 수정 이력은 모두 설명을 위해 만든 가상사례입니다.
한 행이 무엇인지 정해야 ‘중복’도 정할 수 있습니다
다음 자료는 상품 지급을 위한 신청 목록이라고 가정합니다. 한 행은 ‘한 사람이 제출한 한 건의 신청’이며, 이 예시에서는 신청 하나에 상품 하나만 담습니다. 동일인이 다른 신청을 제출할 수 있고, 서로 다른 사람이 같은 이름을 사용할 수도 있습니다. 신청ID는 업무상 신청을 구별하고, 원본행ID는 수신 파일에 들어 있던 각 행을 추적합니다.
| 원본행ID | 신청ID | 신청자ID | 이름 | 상품코드 | 수량 |
|---|---|---|---|---|---|
| R001 | A101 | P01 | 김민수 | M01 | 2 |
| R002 | A102 | P02 | 김민수 | M02 | 5 |
| R003 | A103 | P01 | 김민수 | M01 | 3 |
| R004 | A104 | P03 | 이서연 | M02 | 4 |
| R005 | A104 | P03 | 이서연 | M02 | 4 |
| R006 | A105 | P04 | 박지우 | M01 | 1 |
이 표에서 김민수라는 이름은 세 번 나옵니다. 그러나 P01과 P02는 다른 사람이고, P01의 A101과 A103도 다른 신청입니다. 이름 열만 기준으로 중복 제거하면 동명이인의 신청과 같은 사람의 재신청을 함께 잃을 수 있습니다. 상품코드 M01도 세 번 나오지만, 같은 상품을 신청했다는 사실은 같은 신청이라는 뜻이 아닙니다.
반면 R004와 R005는 업무 필드가 같습니다. 여기서는 A104 한 건이 수신 과정에서 두 번 들어온 것으로 확인됐다는 조건을 추가합니다. 이 조건에 따라 R004를 남기고 R005를 제외합니다. 실제 업무에서 단지 값이 닮았다는 이유만으로 같은 결론을 내리면 안 됩니다. 주문 상세처럼 한 주문에 여러 상품 행이 붙는 자료라면 주문ID 하나가 아니라 주문ID와 상세행ID의 조합 등이 필요합니다.
‘중복’은 셀 색깔이 아니라 업무 규칙입니다. 같은 사람에게 상품을 한 번만 지급하려는 정책과, 중복 수신된 레코드를 제거하려는 작업도 다릅니다. 전자는 유효한 신청 중 무엇을 채택할지 결정하는 선별이고, 후자는 같은 기록의 사본을 줄이는 작업입니다. 둘을 섞으면 삭제된 신청을 나중에 설명하기 어렵습니다.
원본시트·작업시트·제외기록을 나눕니다
정렬하기 전에 통합문서 사본을 저장합니다. 그 안에 수정하지 않을 원본, 실제 정리를 진행할 작업, 빠진 행의 근거를 남길 제외기록 시트를 마련합니다. 중복 제거는 값을 실제로 삭제하므로, Microsoft도 원본 범위를 다른 시트나 통합문서로 복사해 둘 것을 권합니다. 중복 값 찾기와 제거
원본행ID는 R001처럼 각 수신 행에 하나씩 부여한 고정값으로 둡니다. 위 표에서는 중복 신청 A104에도 R004와 R005라는 서로 다른 행ID가 있습니다. 두 번호는 ‘서로 다른 신청’이라는 뜻이 아니라 ‘원본에서 각각 어느 행이었는지’를 표시합니다. 신청ID만으로는 동일 신청의 사본 둘을 따로 추적할 수 없기 때문입니다.
행ID를 만든 뒤 원본시트를 확정하고 작업시트에 그대로 복사합니다. 순번을 수식으로 만들었다면 정리 전에 값으로 붙여넣어 고정합니다. 특히 현재 행번호에 따라 결과가 달라지는 수식을 식별자처럼 쓰면, 정렬 후 번호가 다시 계산되면서 추적 기준이 흔들릴 수 있습니다. 고정 ID와 현재 시트의 행번호는 역할이 다릅니다.
원본·작업·제외기록을 한 통합문서 안에 둬도 파일 자체가 손상되거나 잘못 덮어써질 수 있으므로 최초 사본은 따로 남깁니다. 공동작업 파일이라면 다른 사람이 수정 중인지 확인한 뒤 합의한 복사본에서 정리합니다. 원본을 보호한다는 이유로 정상적인 공동작업 내용을 무시하거나, 편집 중인 파일 전체를 일방적으로 이전 상태로 되돌려서는 안 됩니다.
보기 좋은 목록을 정렬 가능한 표로 바꿉니다
빈 줄·머리글·합계행을 정리합니다
정렬 범위 안에는 머리글 한 줄과 같은 의미의 데이터 행이 연속해서 들어가게 합니다. 표 중간의 빈 행·빈 열은 범위 자동 인식을 어렵게 하고, 문서 제목이나 중간 설명 행은 데이터와 섞일 수 있습니다. ‘신청목록’, ‘오전 접수분’ 같은 문구는 작업 표 바깥으로 옮기고, 업무상 구분이 필요하면 접수구분 열로 기록합니다. 워크시트 자료 구성
기존 자료에 들어 있는 “합계 19” 같은 행도 본문 데이터에서 분리합니다. 이 행을 수량에 포함한 채 다시 더하면 개별 수량과 합계를 중복 계산하게 됩니다. 합계가 맨 아래에 있어야 한다는 이유로 빈 신청ID를 가진 합계행을 상품 신청 한 건처럼 표에 섞어 놓지 않습니다. 검산 수식은 별도 영역에 둡니다.
병합된 이름 셀이 여러 신청 행을 가로지르고 있다면, 병합을 해제한 뒤 각 행이 누구의 신청인지 확인해 채웁니다. 병합 해제만으로 아래 행들의 정보가 자동으로 완성되었다고 가정하지 않습니다. 빈 이름을 모두 위쪽 이름으로 채우는 방식도 원본의 묶음 관계가 확인된 구간에 한정해야 합니다. 병합 때문에 정렬이 막힌다면 시각적 배치를 먼저 풀어야 하며, 어느 값이 어느 행에 속하는지 불분명하면 그 상태에서 정렬을 멈춥니다. 셀 병합과 병합 해제
전체 범위를 선택하고 머리글을 확인합니다
위 가상자료를 A1:F7에 두었다면 범위 전체를 선택합니다. 삽입(Insert) → 표(Table)에서 범위가 A1:F7인지, 머리글을 포함한 표로 인식하는지 확인해 Excel 표로 만듭니다. 표 디자인의 표 이름 항목에서 예시의 작업 표 이름을 작업표로 정합니다. 이후 표 이름과 열 이름을 사용하는 수식을 쓸 때 이 이름이 일치해야 합니다. 표 만들기와 서식 지정 표의 구조적 참조 Excel 표 이름 바꾸기
표를 만드는 목적은 줄무늬를 예쁘게 넣는 데 있지 않습니다. 원본행ID부터 수량까지 한 덩어리로 취급할 범위를 분명히 하는 것입니다. 다른 메모가 G열에 붙어 있고 그 메모도 해당 신청의 일부라면 G열까지 표에 포함해야 합니다. 표 밖의 메모가 정렬 후에도 같은 사람을 설명할 것이라고 기대해서는 안 됩니다.
일반 범위를 그대로 사용할 때도 전체 행 관계에 필요한 열을 모두 선택합니다. 선택 영역 확장(Expand the selection) 경고가 나오면 단일 열만 이동시키려던 것이 아닌지 확인합니다. 행 단위 자료 정리라면 현재 선택 영역으로 정렬(Continue with the current selection)을 무심코 선택하지 않습니다. 이미 범위 인식이 잘못됐다면 확장만 누를 것이 아니라 취소 후 정확한 범위를 다시 잡습니다.
숨긴 행과 필터로 감춘 행을 확인합니다
전체 자료를 정리할 때는 현재 필터 조건을 기록하고 필터를 해제한 뒤, 수동으로 숨긴 행과 열도 표시합니다. 접혀 있는 그룹이나 일부만 보이도록 만든 보기 상태까지 확인합니다. Microsoft도 범위를 수정하기 전에 숨긴 행과 열을 표시하도록 안내합니다. 보이지 않는다고 처리 대상에서 제외된 것이라고 판단하지 않습니다.
특정 상품만 대상으로 작업해야 한다면 ‘지금 필터로 보이는 부분’을 곧바로 삭제 기준으로 삼기보다, 조건에 맞는 자료를 별도 작업 표로 추출하고 추출 행수와 ID를 확인합니다. 전체 표 정리인지 일부 집합 정리인지가 먼저 정해져야 뒤의 행수 검산도 같은 대상을 비교하게 됩니다.
정렬 전에 숫자·날짜·공백의 의미를 맞춥니다
수량에 숫자 2와 텍스트로 저장된 2가 섞여 있으면 기대한 숫자 순서와 달라질 수 있습니다. 셀의 정렬 방향이나 표시 형식만 보고 자료형을 확정하지 말고, 수량 열에서 ISNUMBER 같은 검사로 실제 숫자인지 확인합니다. 숫자가 아닌 수량은 원문과 단위를 점검해 변환하며, 상품코드나 신청자ID까지 한꺼번에 숫자로 만들지 않습니다. IS 계열 함수
예를 들어 수량 열에 5개, 공백만 있는 값, 숫자 0이 섞여 있다면 셋을 같은 의미로 처리할 수 없습니다. ‘5개’는 수량 5와 단위 개로 나눌 규칙을 정할 수 있지만, 빈값은 미입력일 수 있고 0은 취소 또는 수량 없음의 명시적 값일 수 있습니다. 공백을 자동으로 0으로 채우기 전에 업무 규칙을 확인하고, 해결되지 않은 행은 보류 목록으로 구별합니다.
날짜 정렬도 마찬가지입니다. 날짜처럼 보이는 문자가 날짜형인지 확인하고, 일·월 순서와 시간대가 정해진 자료인지 살핍니다. 최신 기록을 골라야 하는 작업에서는 같은 날짜 안의 시간까지 필요할 수 있습니다. 형식만 날짜로 지정했다고 잘못 읽힌 날짜나 텍스트가 모두 정상화됐다고 보지 않습니다. 텍스트에서 날짜로 바꾸는 해석에는 원문의 지역 규칙이 적용됩니다. Power Query 자료형
앞뒤 공백을 정리할 때는 원문 열을 덮어쓰기 전에 정리용 열을 만듭니다. =TRIM(D2)는 일반 공백을 다루지만 단어 사이의 연속 공백도 하나로 줄입니다. 따라서 이름·코드의 공백이 의미 있는지 판단하지 않은 채 모든 열에 적용하지 않습니다. 줄바꿈 없는 공백 문자처럼 TRIM만으로 제거되지 않는 문자도 있습니다. 보이지 않는 차이가 남으면 문자 종류를 확인한 뒤 해당 규칙을 적용합니다. TRIM 함수
정리용 열을 추가했다면 정렬과 중복 기준으로 어느 열을 사용할지도 정합니다. 원문 이름과 정리된 이름을 함께 보존할 수는 있지만, 두 열 중 하나를 그때그때 임의로 골라 쓰면 같은 파일 안에서도 중복 판단이 바뀝니다. ‘이름 양끝의 일반 공백 제거’처럼 수행한 변경을 기록하고, 원본 대조에서는 그 변경이 허용된 열만 별도로 판단합니다.
다중 정렬은 우선순위와 동점 기준까지 지정합니다
위 자료를 상품별로 모으고, 같은 상품 안에서 수량이 많은 신청부터 보고 싶다고 하겠습니다. 작업표 전체를 대상으로 데이터(Data) → 정렬(Sort)을 열고 첫 기준을 상품코드 오름차순, 다음 기준을 수량 내림차순으로 지정합니다. 수준 추가(Add Level)로 조건을 추가하고, 맨 위 조건이 먼저 적용되는지 확인합니다. 머리글 포함 여부도 점검합니다.
동점일 때의 순서를 고정하려면 원본행ID 오름차순을 마지막 보조키로 둡니다. 이때 행ID는 접수 시각을 뜻하지 않습니다. 단지 같은 상품·같은 수량의 행을 매번 예측 가능한 순서로 놓으려는 기준입니다. 실제 선착순 처리가 목적이라면 확인된 접수시각과 신청ID 등 업무 규칙에 맞는 키를 사용해야 합니다.
가상자료에서 기대하는 순서는 M01의 R003·R001·R006, 이어서 M02의 R002·R004·R005입니다. 수량은 각각 3·2·1과 5·4·4입니다. 수량이 같은 R004와 R005는 마지막 행ID 기준으로 순서를 정했습니다. 이 결과와 다르면 우선순위, 숫자 자료형, 선택 범위를 확인합니다.
열마다 정렬 버튼을 따로 눌러 원하는 결과를 쌓으려 하기보다 정렬 창에서 조건을 한 번에 구성하는 편이 의도를 기록하기 쉽습니다. 날짜 내림차순을 적용한 다음 다시 이름 오름차순을 단독으로 적용하면, 앞에서 정한 전체 날짜 순서와는 다른 결과가 될 수 있습니다. 정렬 결과가 원하는 목적에 맞는지 확인하고 그 조건을 작업 기록에 남깁니다.
합계가 같아도 행 관계가 깨지는 가상사례
원본 수량은 위에서부터 2·5·3·4·4·1이고 합계는 19입니다. 실수로 수량 열만 오름차순 정렬하면 1·2·3·4·4·5가 됩니다. 합계도 19이며 행수도 6입니다. 하지만 변경된 세 행만 추려 보면 문제는 분명해집니다.
| 신청ID | 신청자ID·이름 | 원래 수량 | 수량 열만 정렬한 뒤 |
|---|---|---|---|
| A101 | P01·김민수 | 2 | 1 |
| A102 | P02·김민수 | 5 | 2 |
| A105 | P04·박지우 | 1 | 5 |
이 세 행의 합은 전후 모두 8입니다. 바뀌지 않은 나머지 세 행의 합이 11이므로 전체 합도 19로 같습니다. 그렇다고 A101에서 1개가 줄고 A102에서 3개가 줄어 A105로 4개가 넘어간 오류가 사라지지는 않습니다. 동명이인 두 명의 이름이 여전히 김민수라고 표시되기 때문에 이름만 훑는 검사로는 문제를 더 놓치기 쉽습니다.
또 이름과 신청자ID 두 열만 함께 정렬하고 상품·수량을 남겨 두는 실수도 가능합니다. 두 열끼리는 짝이 맞아 보이지만 신청 전체의 연결은 끊깁니다. 검사 단위는 눈에 익은 두 열이 아니라 한 신청을 구성하는 모든 필드여야 합니다. 실제 정렬은 각 행을 통째로 옮기는 작업이어야 하고, 검산은 그 조건이 지켜졌는지를 확인해야 합니다.
원본과 대조하는 검산 수식을 만듭니다
행수·빈 ID·숫자 개수를 먼저 확인합니다
작업표 바깥의 검산 영역에 =ROWS(작업표[원본행ID])로 데이터 행수를 계산합니다. 위 자료의 정렬 전후 결과는 모두 6이어야 합니다. =COUNTA(작업표[원본행ID])도 6인지 확인하면 실제 ID가 채워졌는지 점검할 수 있습니다. 이 예시의 ID는 수식이 아닌 고정 텍스트이며 빈값을 허용하지 않습니다. ROWS 함수 범위의 셀 개수 세기
수량은 =COUNT(작업표[수량])이 6, =SUM(작업표[수량])이 19인지 확인합니다. 합계만 같고 COUNT가 작다면 숫자가 아닌 수량이 섞였을 가능성을 점검합니다. 검사한 기준값은 다른 위치에 값으로 기록해 둡니다. ‘정렬 전’이라고 적어 놓은 수식이 계속 작업표를 참조하면, 작업 후 값이 바뀌면서 기준값도 함께 바뀌기 때문입니다. COUNT 함수 SUM 함수
현재 보이는 행만 셀 때는 =SUBTOTAL(103,작업표[원본행ID]), 보이는 수량은 =SUBTOTAL(109,작업표[수량])을 별도로 사용합니다. 103과 109는 필터로 빠진 행뿐 아니라 수동으로 숨긴 행도 제외하는 방식입니다. 전체 행수·합계와 현재 표시된 집합의 값을 구분해 이름 붙여 둡니다. 필터를 켠 뒤 숫자가 줄었다는 사실은 삭제가 일어났다는 증거가 아닙니다. SUBTOTAL 함수
같은 줄끼리가 아니라 같은 ID끼리 맞춥니다
정렬 후 작업시트의 2행은 원본시트의 2행과 다른 신청일 수 있습니다. 단순히 F2와 원본!F2를 비교하면 정상 정렬도 오류처럼 보입니다. 고유한 원본행ID로 원본 위치를 찾은 뒤 해당 행의 업무 필드를 비교해야 합니다.
수식 예시는 원본시트 이름이 원본, 표 위치가 A1:F7이며 작업시트도 같은 여섯 열 순서를 유지하는 조건입니다. 실제 자료에서는 원본의 마지막 행과 열 위치를 바꿉니다. 먼저 원본 각 행에서 =COUNTIF($A$2:$A$7,A2)가 모두 1인지 확인합니다. 행ID가 중복되면 먼저 번호를 다시 부여해 원본 기준본을 확정합니다. 여기의 ID는 R001처럼 대문자·숫자로 통일하고 와일드카드 문자를 쓰지 않은 값입니다. 값의 출현 횟수 세기
작업시트 G열에 ‘원본위치’를 만들고 G2에 다음 수식을 넣습니다. MATCH의 마지막 인수 0은 정확히 일치하는 값을 찾도록 지정합니다. 원본행ID가 없으면 오류가 나오며, 이것도 수정 없이 넘어갈 결과가 아닙니다. MATCH 함수
=MATCH(A2,'원본'!$A$2:$A$7,0)
H열은 ‘행관계일치’로 정하고 H2에 다음 수식을 넣습니다. 신청ID·신청자ID·이름·상품코드는 문자열을, 수량은 숫자 값을 비교합니다. G열과 H열 수식을 작업 데이터 마지막 행까지 적용합니다. 이 두 검산 열도 이후 정렬 범위와 함께 움직이도록 작업표에 포함합니다. EXACT 함수 INDEX 함수 AND 함수 IFERROR 함수
=IFERROR(AND(EXACT(B2,INDEX('원본'!$B$2:$B$7,G2)),EXACT(C2,INDEX('원본'!$C$2:$C$7,G2)),EXACT(D2,INDEX('원본'!$D$2:$D$7,G2)),EXACT(E2,INDEX('원본'!$E$2:$E$7,G2)),F2=INDEX('원본'!$F$2:$F$7,G2)),FALSE)
정렬만 했다면 모든 행이 TRUE여야 합니다. 앞서 수량 열만 정렬한 오류에서는 R001·R002·R006이 FALSE가 됩니다. FALSE를 빈칸으로 가리거나 정상으로 바꾸지 말고 해당 ID의 원문 필드를 대조합니다. 이 수식은 원본이 그대로 보존되고, ID가 고유하며, 수량이 숫자이고, 정렬 외의 내용 변경이 없다는 조건에서 사용합니다.
공백 정리나 자료형 변경을 먼저 수행했다면 그 변경이 이 비교에 나타날 수 있습니다. 그런 경우에는 변경 전후 값을 별도 열에 보존하고, 승인된 정리가 끝난 시점을 정렬 검산의 기준본으로 따로 확정합니다. 허용한 내용 변경과 정렬 때문에 생긴 오류를 구분하는 방식입니다.
전 행 비교와 함께 경계 사례도 직접 봅니다. 동명이인인 P01·P02, 같은 사람의 다른 신청 A101·A103, 수량이 가장 크거나 작은 행, 중복 후보 A104를 찾아 업무상 의미가 유지됐는지 확인합니다. 표본 몇 개의 통과만으로 전체를 보증하지는 않지만, 규칙 자체를 잘못 설계한 문제는 이런 사례 대조에서 드러날 수 있습니다.
중복 제거는 표시·판단·기록 뒤에 실행합니다
색칠된 값은 삭제 명령이 아닙니다
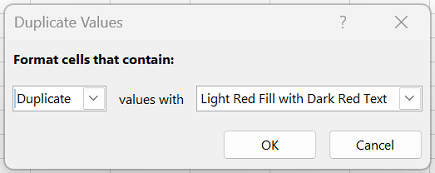
신청ID 열을 선택하고 홈(Home) → 조건부 서식(Conditional Formatting) → 셀 강조 규칙(Highlight Cells Rules) → 중복 값(Duplicate Values)으로 후보를 표시합니다. Microsoft가 안내하는 기능도 먼저 중복 값을 강조해 검토하는 용도입니다. 이름 열에 적용해서 김민수가 반복된다는 사실을 확인할 수는 있지만, 그것만으로 신청 중복을 판단하지는 않습니다.
이 예시에서는 신청ID A104 두 행이 후보입니다. 중복 표시는 반복되는 값 모두에 나타날 수 있으므로 어느 행을 남길지는 따로 정해야 합니다. 두 행의 신청자ID·상품코드·수량 등 전체 업무 정보를 비교합니다. 같은 신청ID인데 수량이 다르다면 단순 사본이 아니라 수정본 또는 충돌 자료일 수 있습니다. 그런 행은 즉시 삭제하지 않고 원본 시스템이나 변경 규칙을 확인합니다.
조건부 서식의 일반 중복 값 표시는 여러 열의 조합을 업무 키로 정의하는 검사를 자동으로 대신하지 않습니다. 업무 키가 주문ID와 상세행ID라면 두 조건을 함께 검사해야 합니다. 단순히 두 열 각각에 색을 칠하는 것과 두 값의 조합이 같은 행을 찾는 것은 다른 작업입니다. COUNTIFS처럼 여러 조건을 함께 검사하는 방식이 필요한 이유입니다.
선택 범위와 중복 기준 열을 구분합니다
먼저 작업표 전체를 선택하고 데이터 → 중복된 항목 제거(Remove Duplicates)를 엽니다. 대화상자의 체크박스는 ‘이 열만 삭제하겠다’가 아니라 ‘이 열들을 조합해 같은 기록인지 비교하겠다’는 뜻입니다. 기준 열에서 중복으로 판단되면 선택 범위 안의 해당 행 전체가 제거됩니다. 표 밖에 남겨 둔 별도 정보까지 함께 맞춰진다는 뜻은 아닙니다. 고유값 필터와 중복 제거
이번 가상자료에서는 동일 신청의 사본임을 확인했으므로 신청ID·신청자ID·이름·상품코드·수량, 즉 B~F열을 비교 기준으로 사용합니다. 원본행ID A열과 검산용 G·H열은 기준에서 뺍니다. 원본행ID까지 포함하면 R004와 R005가 서로 달라 중복으로 잡히지 않습니다. 그렇다고 원본행ID를 선택 범위 자체에서 빼는 것이 아닙니다. 행ID도 해당 행과 함께 삭제되도록 표 안에 있어야 합니다.
실행 전 R005의 원래 행 전체를 제외기록에 복사합니다. 제외 사유는 ‘A104 중복 수신’, 남길 원본행ID는 R004, 적용 기준은 B~F열 일치라고 기록합니다. 더 큰 자료에서는 후보와 보존 대상을 먼저 표시해 검토하고, 제외기록에 적힌 ID 집합과 실제로 빠진 ID 집합을 비교합니다. 삭제 후 ‘1개 제거’라는 알림만 남기는 것보다 어떤 신청이 왜 빠졌는지 확인하기 쉽습니다.
Microsoft는 목록의 첫 번째 항목을 남기고 같은 항목을 제거한다고 안내합니다. 따라서 이 사례에서 R004가 앞에 있는지 확인하고 실행한 뒤, 정말 R004가 남았는지 다시 확인합니다. 빈셀이나 공백 등이 결과 개수에 영향을 줄 수 있으므로 알림의 숫자는 작업표·제외기록 검산을 대체하지 않습니다.
최신 날짜를 남기는 작업은 수정 이력인지부터 확인합니다
별도의 가상사례로 A201 신청의 수정본이 두 개 있다고 하겠습니다. 하나는 2026년 10월 6일 10시의 수량 2, 다른 하나는 10월 7일 9시의 수량 4입니다. 업무 규칙이 ‘동일 신청의 최종 상태 한 건만 사용한다’이고 두 시각의 기준이 같다면, 뒤의 기록을 보존할 수 있습니다. 하지만 이것이 서로 다른 두 거래라면 수량을 합산하거나 거래별로 유지해야 하며, 오래된 거래를 중복이라고 없애서는 안 됩니다.
최신 상태를 고를 때는 원문 날짜·시간이 올바른 값인지, 같은 ID에 가장 늦은 시각이 하나뿐인지 검사합니다. 날짜 내림차순 뒤 첫 행을 남길 계획이라면 예상 보존 ID를 먼저 기록하고 삭제 후 실제 레코드와 비교합니다. 같은 시각인데 내용이 다른 경우에는 정렬 순서만으로 승자를 정하지 않습니다. 확인된 수정차수 등 우선순위 규칙이 없다면 충돌 자료로 남깁니다.
이처럼 최신본 선택은 날짜 정렬과 중복 제거 버튼 두 개로 완성되는 작업이 아닙니다. 어떤 기록을 유효한 최종 상태로 볼지 결정하는 과정이 먼저 있습니다. 처음 자료의 중복 수신 제거와 지금의 수정본 선택은 이유가 다르므로, 제외 사유도 구분해 기록합니다.
삭제 전후 숫자와 빠진 ID를 함께 맞춥니다
처음의 여섯 행 사례로 돌아오면 정상 정렬은 행수와 수량을 바꾸지 않습니다. 중복 수신 행 R005만 제외한 뒤에는 행수가 6에서 5로, 수량 합계가 19에서 15로 줄어야 합니다. R005는 M02의 수량 4이므로 상품별 변화도 설명할 수 있습니다.
| 검산 구간 | 데이터 행수 | 전체 수량 | M01 수량 | M02 수량 |
|---|---|---|---|---|
| 정렬 전 원본 | 6 | 19 | 6 | 13 |
| 정상 정렬 후 | 6 | 19 | 6 | 13 |
| R005 제외 후 작업본 | 5 | 15 | 6 | 9 |
| 제외기록의 R005 | 1 | 4 | 0 | 4 |
행수는 6 = 5 + 1, 수량은 19 = 15 + 4가 성립합니다. M01은 2+3+1=6으로 유지되고 M02는 5+4+4=13에서 5+4=9로 바뀝니다. 숫자가 이 예상과 다르면 정리 완료로 표시하지 않습니다. 다만 이 등식만으로는 삭제 대상을 확정할 수 없으므로 제외된 ID가 정확히 R005인지도 확인합니다.
예를 들어 수량이 같은 R004를 잘못 제외해도 합계는 같습니다. 두 행의 업무 값이 같더라도 이번 기록상 보존 대상으로 정한 것은 R004이므로, 제외기록에 R005라고 적고 실제로 R004를 지웠다면 추적 기록과 결과가 어긋납니다. 제외 사유와 실제 처리 결과를 일치시켜야 이후 문의에 같은 기준으로 답할 수 있습니다.
원본의 각 원본행ID는 최종 작업본과 제외기록을 합쳐 정확히 한 번 나타나야 합니다. 둘 다 없으면 누락이고, 양쪽에 모두 있으면 아직 삭제하지 않았거나 기록이 중복된 것입니다. COUNTIF로 각각의 출현 횟수를 세어 더한 결과가 1인지 검사할 수 있습니다. 실제 범위에는 머리글과 사유 설명 행을 포함하지 않고, 원본과 같은 규격의 고정 행ID를 사용합니다.
남은 행의 사람·상품·수량 대조도 다시 실행합니다. 중복 제거 전에 TRUE였다는 결과를 보관하는 것만으로 끝내지 않고, 최종 작업본이 원본의 어느 행들로 구성되어 있는지 확인합니다. 수량을 상품별로 보고 싶다면 검산된 거래·신청 자료를 남겨 둔 채 별도 집계표를 만듭니다. 중복 제거는 같은 상품의 수량을 합산하는 기능이 아닙니다. M01 세 신청을 한 건으로 줄이는 것은 요약이 아니라 신청 두 건의 삭제가 될 수 있습니다.
공동작업에서는 정렬과 데이터 변경을 구별합니다
공유 중인 통합문서에서는 정렬·필터가 다른 사람의 보기에 영향을 줄 수 있습니다. 지원되는 환경에서는 보기(View) → 시트 보기(Sheet View) → 새로 만들기(New)로 자신의 정렬·필터 보기를 마련할 수 있습니다. Microsoft의 안내에 따르면 시트 보기는 OneDrive 또는 SharePoint에 저장된 문서에서 사용하며, 로컬 사본에서는 사용할 수 없는 조건이 있습니다. 메뉴 지원 여부와 저장 위치를 확인합니다. 시트 보기 만들기와 관리
중요한 차이는 시트 보기가 개인 복사본은 아니라는 점입니다. 별도 보기 안에서 셀을 수정해도 통합문서의 데이터 변경으로 저장됩니다. 다른 사람에게 정렬 상태를 강요하지 않는 기능과, 데이터 삭제를 나 혼자 시험하는 공간은 다릅니다. 중복 제거처럼 값을 바꾸는 작업은 담당자 간에 처리 시점과 책임 범위를 정하고 복사본에서 검토합니다.
정리 결과를 공유본에 반영할 때도, 복사한 시점 이후 들어온 신규 신청이나 다른 사람의 수정을 덮어쓰지 않도록 대조합니다. 정리본이 내부적으로 맞더라도 오래된 원본을 기준으로 만든 결과일 수 있습니다. 원본 기준 시점과 반영 대상 범위가 확인된 결과만 합치는 방식으로 진행합니다.
행이 뒤섞였다면 즉시 멈추고 복구 경로를 선택합니다
실행 취소가 남아 있는지 먼저 봅니다
문제를 발견하면 추가 정렬이나 이름 맞추기를 멈춥니다. Windows는 Ctrl+Z, Mac은 Command+Z 또는 실행 취소 명령으로 잘못된 작업을 되돌릴 수 있는지 확인합니다. 중간에 다른 편집을 했다면 취소할 단계가 무엇인지 살펴보고 필요한 범위까지만 되돌립니다. 실행 취소와 다시 실행
저장했다는 이유만으로 실행 취소가 무조건 사라지는 것은 아닙니다. Microsoft는 취소 가능한 작업 범위 안에서는 저장 후에도 변경을 취소하고 다시 저장할 수 있다고 설명합니다. 다만 취소할 수 없는 명령이나 기록 한계가 있고, 파일을 닫았다가 다시 연 뒤에도 같은 기록이 남아 있다고 기대해서는 안 됩니다. 실행 취소가 불가능하다고 표시되면 그 경로를 계속 시도하는 대신 보관 원본으로 전환합니다.
원본행ID가 있고 모든 열이 함께 움직인 정상 정렬을 원래 순서로 되돌리려는 경우에는 고정 ID에 담긴 원래 순서로 표 전체를 정렬할 수 있습니다. 그러나 수량 열만 따로 움직여 연결이 깨졌다면 행ID 정렬로 해결되지 않습니다. 잘못 붙은 수량을 그대로 달고 원래 위치로 돌아올 뿐입니다. 이런 상황에는 손상 전 원본의 필드 값이 필요합니다.
저장·종료 후에는 원본 또는 실제 남은 버전을 대조합니다
원본시트나 최초 통합문서 사본이 있다면 그것을 기준으로 작업을 다시 진행합니다. 일부 값만 복원하려면 고유ID로 정확히 연결할 수 있는지 확인하고, 복원 뒤에도 전체 행 관계를 재검사합니다. ID도 함께 잘못 바뀌었거나 여러 후보가 같은 ID를 가진다면 그 상태에서 임의 매칭하지 않습니다.
OneDrive나 SharePoint에 보관된 Office 파일은 조건에 따라 버전 기록(Version History)에서 이전 버전을 열어 볼 수 있습니다. 파일 이름 또는 파일 정보의 버전 기록에서 작업 이전 시각의 버전을 선택하고, 문제가 생기기 전 자료인지 내용을 확인합니다. 단지 목록에서 더 오래됐다는 이유만으로 곧바로 복원하지 않습니다. 실제 이용 경로는 Excel 버전과 저장 환경에 따라 다릅니다. Office 이전 버전 확인
이전 버전으로 복원하면 그 시점 이후의 정상 수정도 현재 결과에서 빠질 수 있습니다. 특히 공동작업에서는 최신 파일 사본을 보관하고, 잘못된 정렬 전후 변경분을 비교한 뒤 전체 복원인지 특정 데이터 복원인지 결정합니다. 버전 이력이 실제로 남아 있고 접근 가능한 환경이어야 하며, 로컬 파일이라면 별도의 백업이 필요할 수 있습니다. 모든 Excel 파일에 복원 가능한 과거 버전이 자동으로 존재하는 것은 아닙니다. Excel 이전 버전 복원
이름만 남은 자료를 보고 김민수의 수량을 손으로 다시 붙이는 일은 피합니다. 위 사례처럼 동명이인이 있고 같은 사람의 신청도 여러 건이면, 이름 하나로는 어느 수량이 어느 신청의 것이었는지 결정할 수 없습니다. 근거가 부족한 행은 원본 재확인 대상으로 분리하고 발급 시스템의 기록과 대조해야 합니다.
정리의 완료 기준은 결과와 근거가 함께 남는 것입니다
최종 파일에는 원본 기준 시점, 정렬 우선순위, 중복 비교 열, 제외 사유와 보존 ID, 작업 전후 행수·수량을 남깁니다. 같은 자료를 다음 달에 다시 정리할 때도 이 기록이 있으면 이름이 같아서 지웠는지, 같은 신청의 사본이라 지웠는지를 다시 추측하지 않아도 됩니다.
제출용 목록에는 필요한 열만 남기더라도 내부 작업본에서는 원본과 제외기록을 보존합니다. 검산 결과가 맞지 않는 부분은 완료 목록에 섞지 않고 보류 이유를 표시합니다. 검산을 통과한 결과와 그 결과를 만든 규칙이 함께 남아 있으면, 다음 담당자도 어느 신청을 보존했고 왜 한 행을 제외했는지 확인할 수 있습니다.