 HOIBLOG
먼저 읽는 요약
2배의 범위 — Magnitude 제작사 비교의 큰 차이는 M4 Pro 48GB 출력 생성에서 나옵니다. 모든 입력 처리나 전체 응답 시간이 절반이 된다는 뜻은 아닙니다.
같은 조건 — 모델·양자화·입출력·추론·하드웨어·캐시·추측 디코딩을 맞추거나 기록해야 엔진 차이를 비교할 수 있습니다.
기능과 품질 — 연결 성공 외에도 필요한 이미지 입력·도구 호출·JSON과 실제 답변의 정확도를 확인합니다.
직접 비교 — 기존 환경을 보존하고 첫 요청·후속 요청을 구분해 첫 토큰 시간, 생성 속도, 완료 시간과 품질을 반복 측정합니다.
Magnitude는 기기에 맞춰 계산 커널을 조정하는 추론 엔진으로, llama.cpp보다 최대 2배 빠르다고 소개합니다. 같은 하드웨어에서도 실행 프로그램의 활용 효율이 달라질 여지는 있습니다. 다만 무엇이 최대 2배 빨라졌는지 봐야 합니다. 질문에 대한 답을 모두 받는 시간이 곧 절반이 된다는 뜻은 아닙니다.
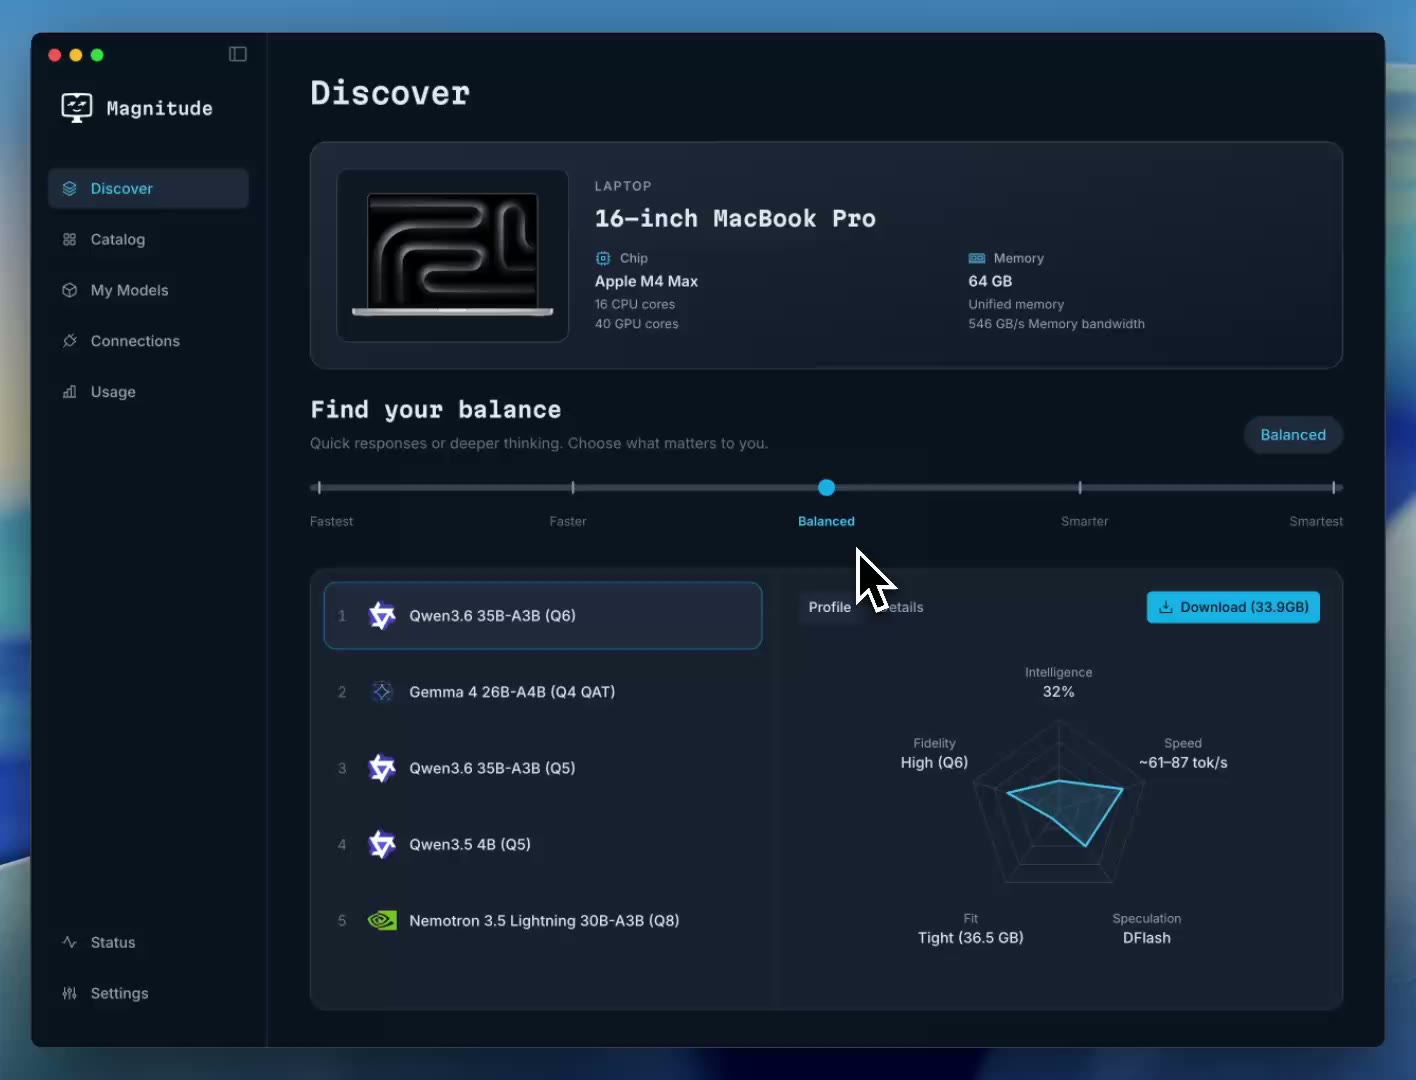
제작사 비교 조건은 Qwen3.6 35B A3B·4비트 양자화·64k 컨텍스트·추측 디코딩 미사용입니다. 아래는 llama.cpp → Magnitude 순서의 반올림된 공개 속도이고 증가율은 제작사 표기입니다. 거의 2배인 차이는 M4 Pro 48GB의 출력 생성이며, 같은 기기의 입력 처리 향상은 9%, DGX Spark의 출력 생성 향상은 19%입니다. M5 Pro 48GB에 그대로 적용할 수 없고, 공식 앱 화면의 M4 Max 64GB도 표의 시험 기기와는 다릅니다.
| 제작사 시험 환경 | 입력 처리·prefill (tok/s) | 출력 생성·decode (tok/s) |
|---|---|---|
| M4 Pro 48GB · Metal | 466 → 507 (+9%) | 30 → 57 (+92%) |
| DGX Spark · CUDA | 2,033 → 2,507 (+23%) | 49 → 58 (+19%) |
입력 처리와 출력 생성, 첫 응답 시간을 구분합니다
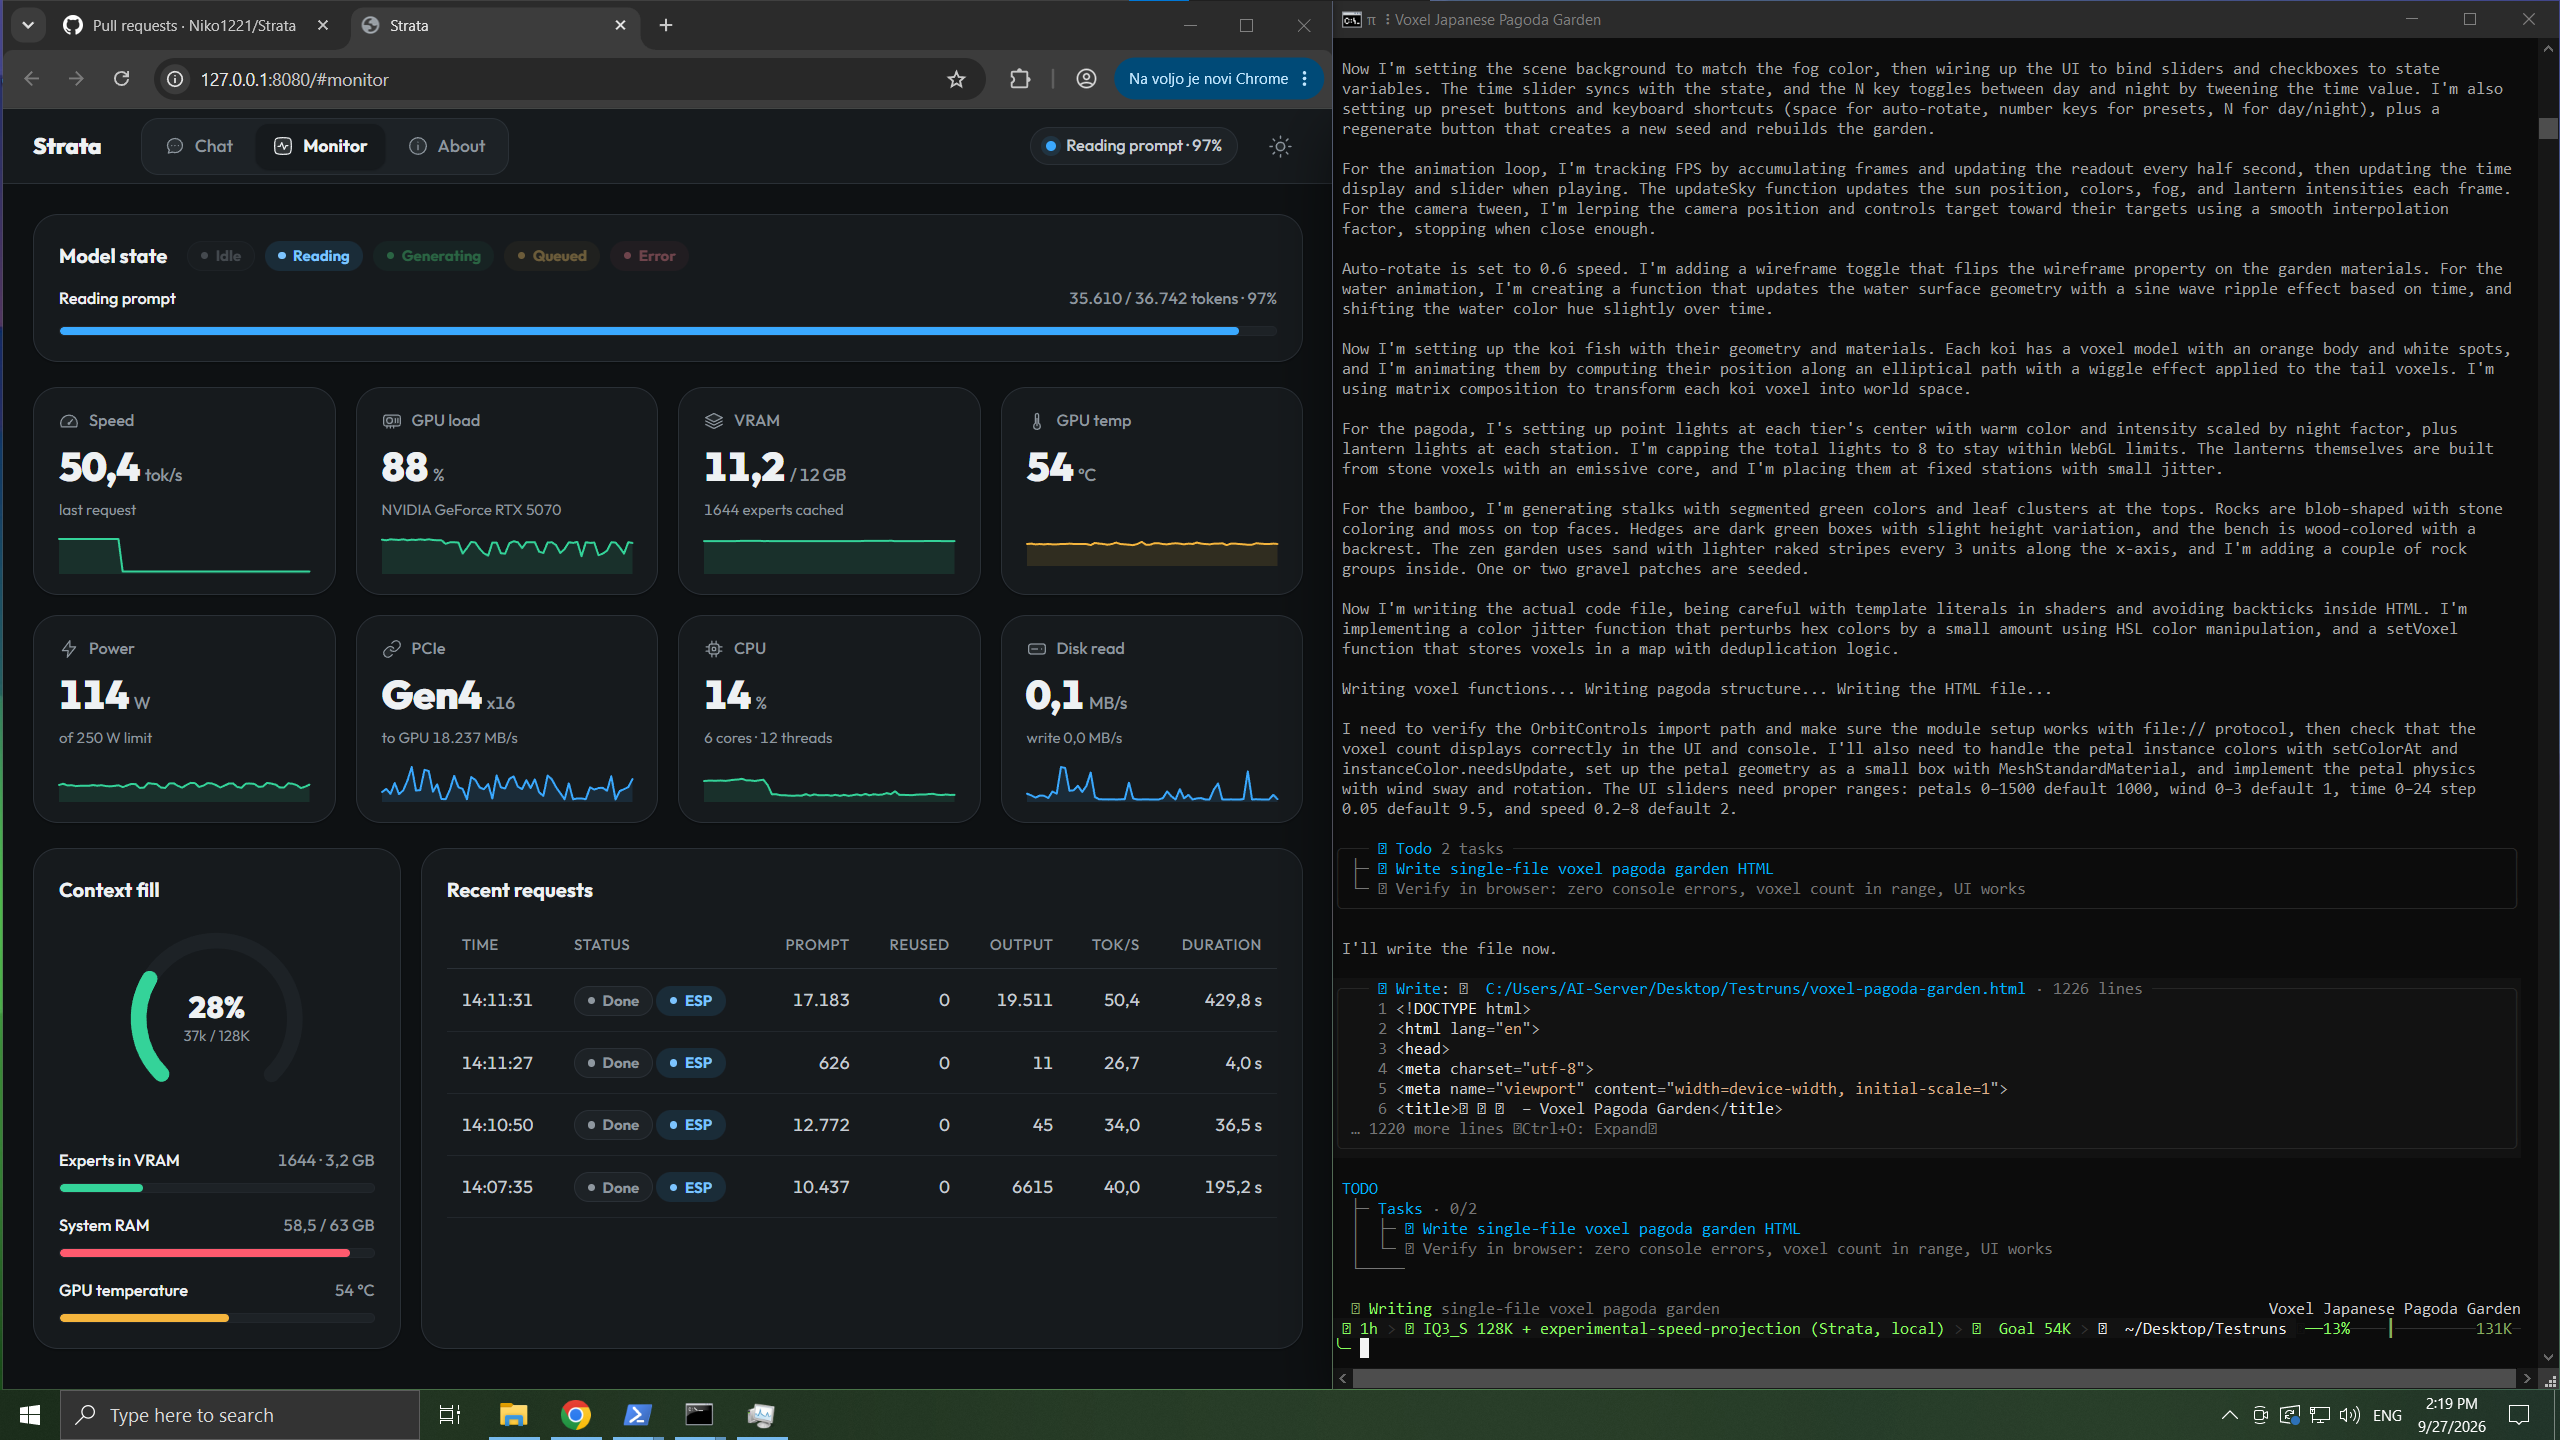
Strata 공식 모니터에는 Reading prompt와 큰 속도 숫자가 함께 보이지만 속도 아래의 last request는 직전 요청을 가리킵니다. 현재 입력 처리 속도와 혼동하지 않아야 합니다. prefill은 질문·대화 기록을 읽는 단계, decode는 답변을 토큰 단위로 생성하는 단계입니다. 첫 토큰까지의 시간인 TTFT에는 모델 로딩·입력 처리·앞선 요청에 따른 대기가 영향을 줄 수 있습니다. 출력이 이어지는 속도와 첫 응답을 기다리는 시간은 다릅니다.
긴 문서를 처음 주고 짧은 요약을 받으면 입력 처리의 비중이 크고, 짧은 질문에 긴 답변을 받으면 decode의 비중이 커집니다. 두 번째 요청이 빨라졌다면 모델이 이미 로딩된 상태인지, 입력까지 재사용하는 캐시 효과인지도 구분해야 합니다. cold 요청, warm 요청, prefix cache를 섞어 비교하면 엔진과 사전 준비의 효과를 나누기 어렵습니다. 입력 토큰 표시가 캐시된 부분을 포함한다면 새로 처리한 양도 봐야 합니다. 출력만 2배 빨라져도 전체 기다림이 절반이 되지는 않습니다.
엔진 외의 모델·양자화·실행 조건을 맞춥니다
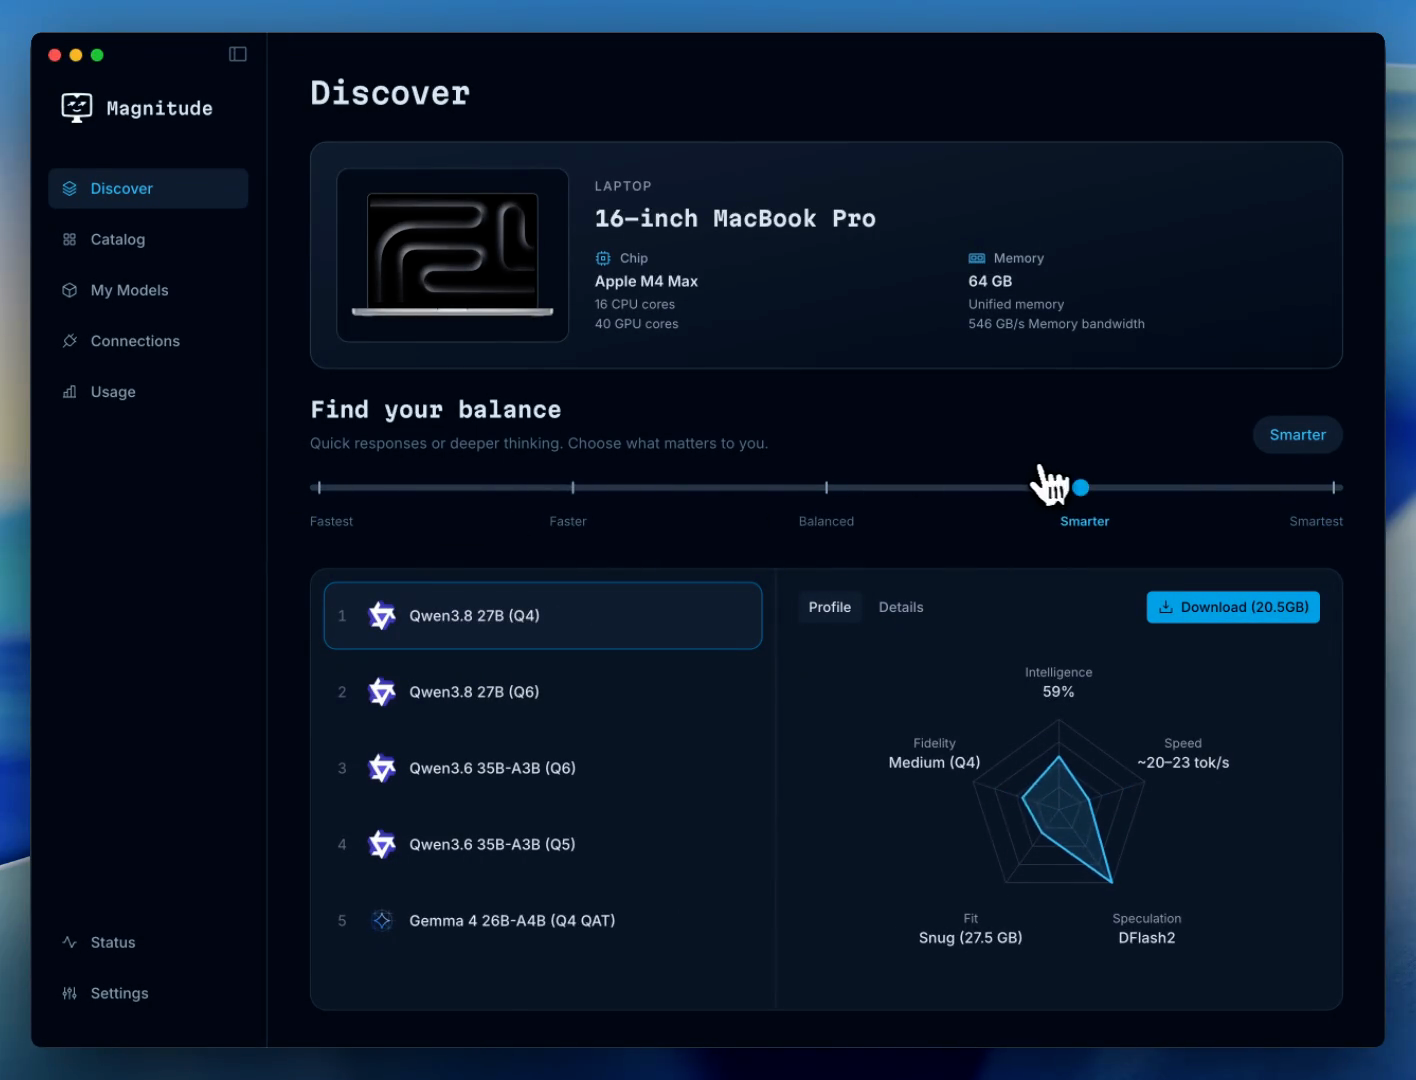
Magnitude의 앞 화면은 Qwen3.6 35B-A3B Q6, Smarter로 옮긴 화면은 Qwen3.8 27B Q4를 선택합니다. 슬라이더 이동으로 모델과 양자화가 함께 바뀐 것입니다. 양자화는 가중치를 적은 비트로 저장하는 방식으로, 낮은 비트는 대체로 용량과 원본 충실도 사이의 절충을 수반합니다. 공식 안내의 Speed는 해당 기기에서의 추정 생성 속도이고 Intelligence 퍼센트는 정답률이 아닌 비교 지수입니다. 다운로드 크기와 실행 메모리도 다릅니다.
엔진만의 효과를 비교하려면 모델 이름뿐 아니라 원본 버전·가중치·실제 양자화 방식까지 맞춰야 합니다. 64k 컨텍스트 표기만으로 실제 입력 문서 길이가 같다고 볼 수도 없습니다. 같은 GPU에서 빨라졌다는 제3자 경험도 설정이 다르면 그 조합에 관한 결과입니다. 보조 모델이 제안한 토큰을 본 모델이 검증하는 추측 디코딩 역시 비교 조건입니다. 제작사 수치와 사용 경험을 참고하되 직접 비교할 때는 아래 항목을 나란히 확인합니다.
| 비교 조건 | 실제로 맞추거나 기록할 내용 |
|---|---|
| 모델·양자화 | 같은 원본 모델·버전·가중치와 실제 양자화 방식. 가능한 경우 동일한 모델 파일을 사용한다. |
| 입력·출력 | 같은 문서·질문·대화 기록·시스템 지시와 실제 입력 토큰 수. 출력 상한과 실제 생성 길이도 함께 본다. |
| 샘플링·추론 | 답변을 고르는 temperature·top-p와 지원되는 범위의 seed를 맞춘다. 추론 기능의 켜짐 여부와 생각에 쓸 분량(reasoning budget)도 맞춘다. |
| 하드웨어·실행환경 | 같은 칩·GPU 코어 구성·메모리, 전원 모드·온도·동시 작업 조건. OS와 각 엔진의 버전도 기록한다. |
| 캐시·동시 요청 | 컨텍스트와 이전 계산을 보관하는 KV cache의 설정·정밀도, 모델 로딩 상태, 입력 캐시 재사용량을 구분한다. 단일 요청과 동시 요청은 따로 비교한다. |
| 추측 디코딩 | 우선 양쪽을 끈 조건으로 구분하고, 켠 비교는 활성화 여부뿐 아니라 방식과 draft(보조) 모델도 기록한다. |
연결 뒤에 필요한 모델과 기능이 작동하는지 확인합니다
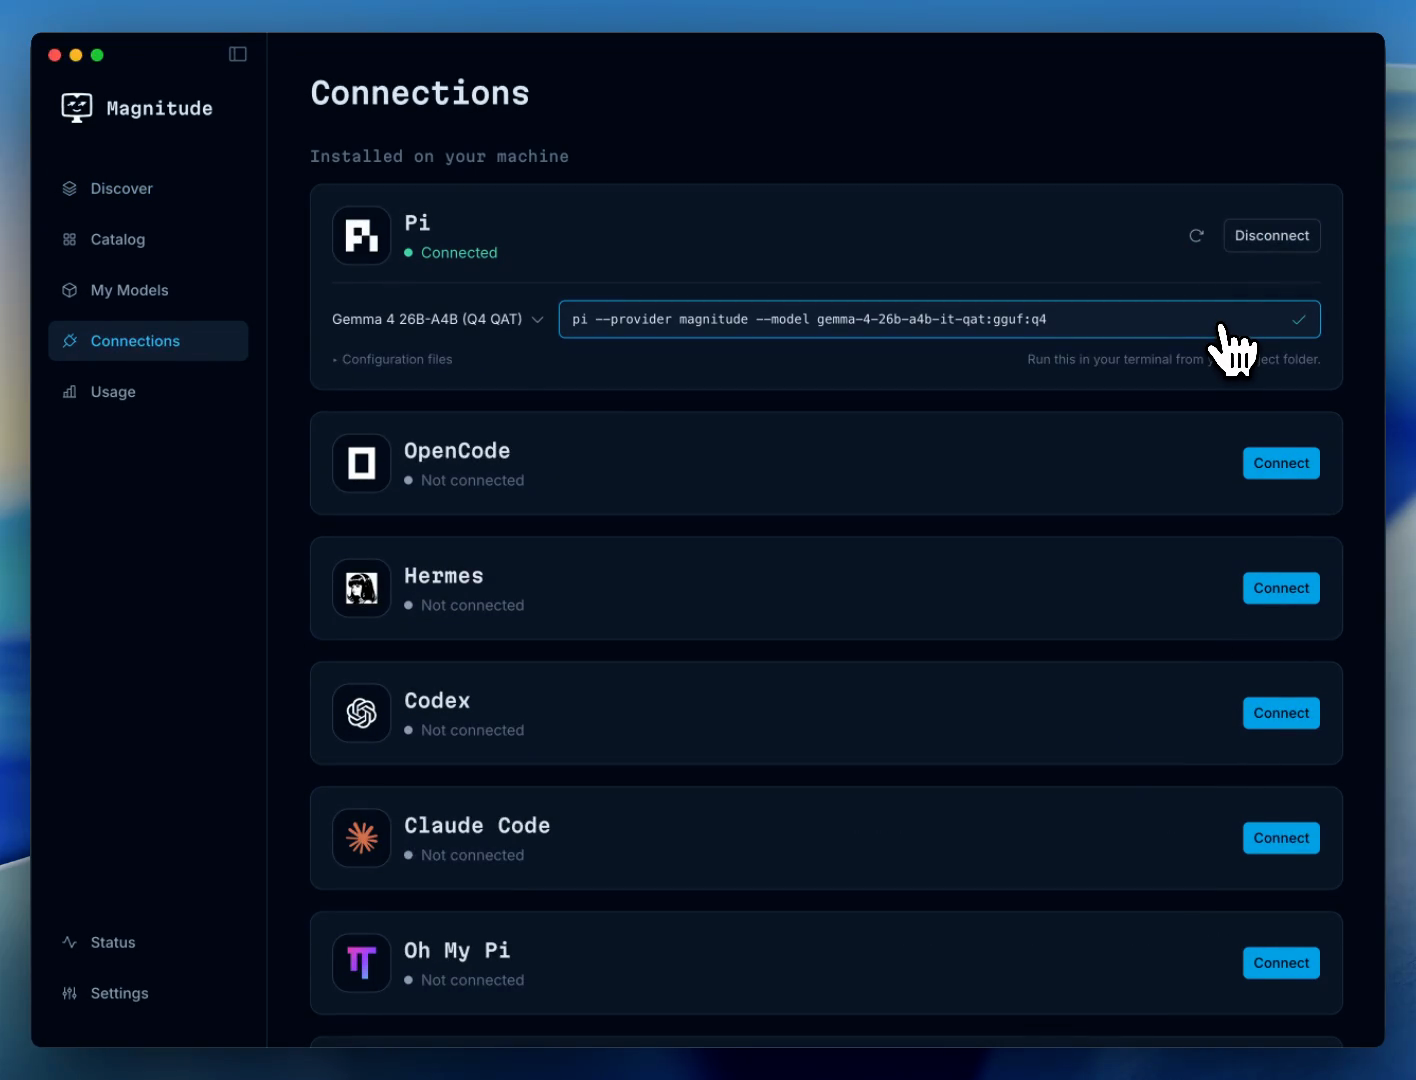
Magnitude의 Connections에는 Pi 연결과 다른 도구 연결 항목이 보입니다. 하지만 연결 성공과 작업 성공은 다릅니다. 이미지 입력·도구 호출·정해진 JSON 출력이 필요하다면 모델이 해당 기능을 갖추고 엔진과 연결 도구가 함께 처리하는지 확인해야 합니다. 문장이 빨리 나와도 필요한 도구가 작동하지 않으면 작업은 끝나지 않습니다.
Strata는 Qwen3.8-Flash-Next를 중심으로 NVIDIA·AMD GPU의 VRAM 12GB 이상과 Windows·Linux 환경을 안내합니다. Apple Silicon에서 모든 모델을 실행하는 범용 프로그램으로 볼 대상은 아닙니다. 특정 모델·하드웨어에 최적화한 엔진은 속도와 지원 범위를 함께 봐야 합니다. 단일 요청의 생성 속도와 여러 요청을 동시에 처리하는 능력도 다릅니다. 필요한 모델·기능을 지원하지 않으면 빠른 비교값만으로 대체재가 되지는 않습니다.
생성 속도와 실제 답변 품질을 함께 봅니다
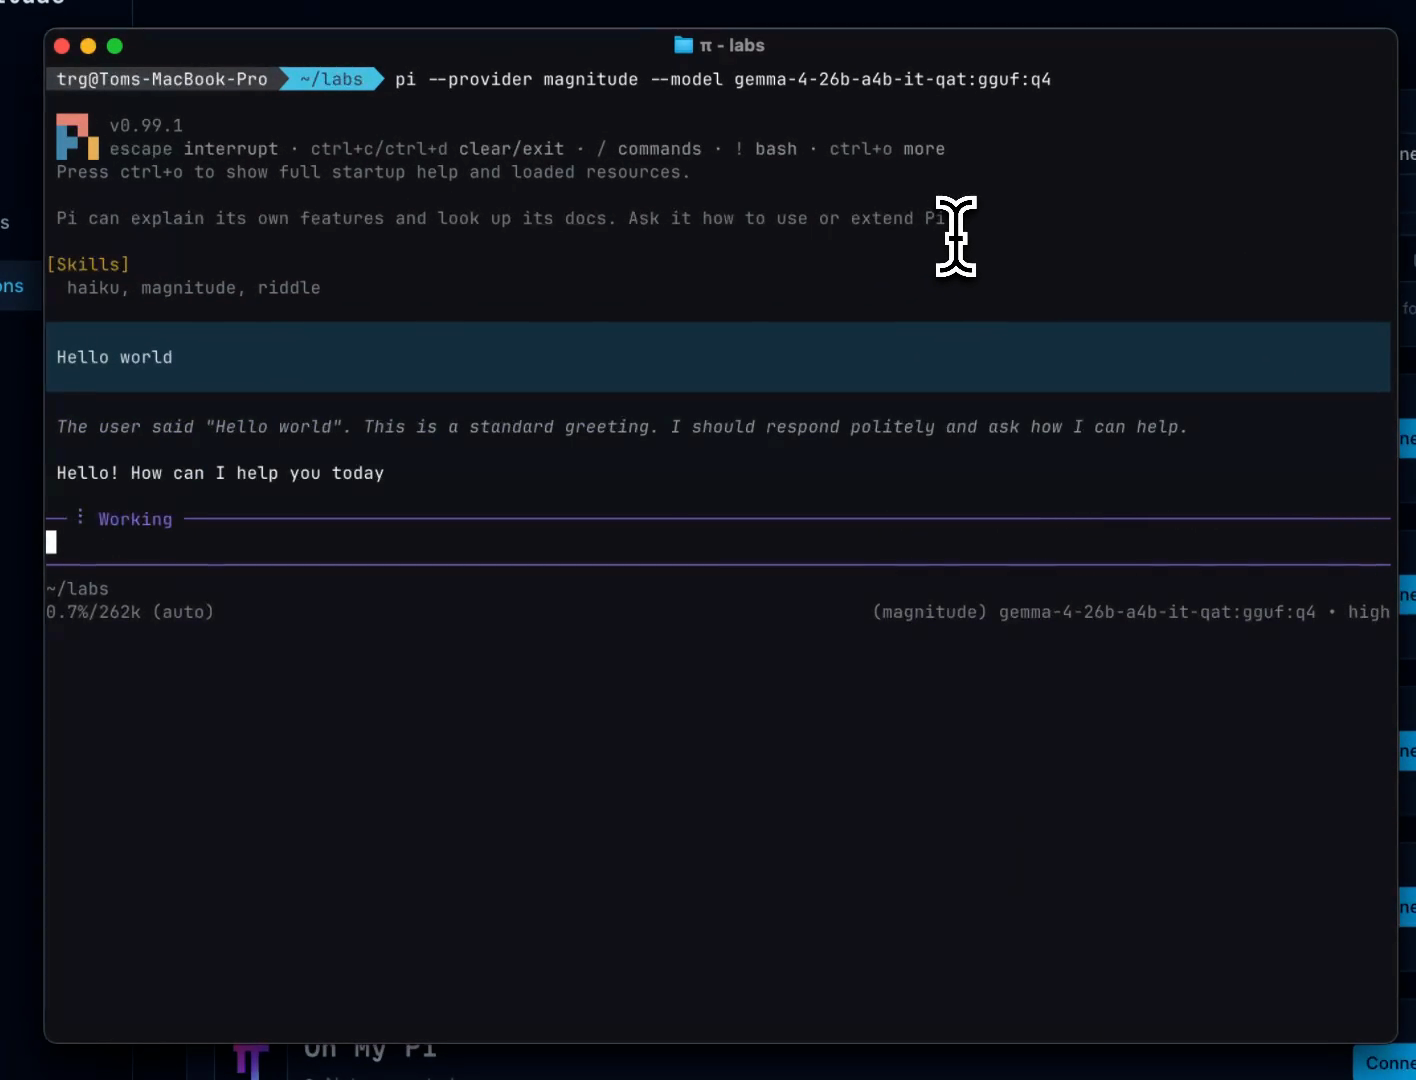
Pi 공식 데모의 Hello world 응답은 연결 뒤 답변을 받는 장면입니다. 긴 한국어 문서의 사실·숫자·누락 여부나 지시 준수까지 보여주지는 않습니다. 필요한 형식, 도구 호출, JSON 출력이 실제로 쓸 수 있는지도 확인해야 합니다. 양자화를 낮추거나 추론 분량을 줄여 얻은 속도라면 답변 품질의 차이를 특히 살펴봅니다. 빠른 답변을 고치는 시간이 늘었다면 실제 작업 시간은 줄지 않을 수 있습니다.
총평: 같은 일을 같은 수준으로 마치는 시간을 비교합니다
기존 환경은 남겨두고 실제로 맡길 짧은 질문과 긴 자료를 같은 조건으로 비교합니다. 출력 상한과 실제 생성 길이, 첫 토큰 시간, 이후 생성 속도, 전체 완료 시간과 품질을 함께 기록합니다. 첫 요청과 후속 요청을 나누고 최고 기록 한 번보다 반복 범위를 봅니다. 제작사 수치는 특정 조건에서 출력이 거의 2배 빨라질 수 있음을 보여줍니다. 내 작업 전체가 2배 빨라진다는 보증은 아니며, 교체할 이유는 같은 일을 같은 수준으로 마치는 데 실제로 덜 걸리는 시간입니다.